La función más llamativa es la replicación de voz a partir de una muestra de audio de solo 30 segundos. Google indica que puede recrear un perfil vocal consistente siempre que se trate de la propia voz del usuario o de una voz para la que se tengan los derechos necesarios.
Sin embargo, existe una limitación importante para España: Google especifica que la replicación de voz mediante Google AI Studio no está disponible actualmente en el Espacio Económico Europeo. Por tanto, la capacidad existe dentro de Gemini 3.8 TTS, pero no debe confundirse con una función ya accesible para cualquier usuario español desde AI Studio.
Gemini 3.8 puede replicar una voz desde una muestra de 30 segundos
Google denomina a esta función Voice replication. El sistema utiliza una referencia de audio de 30 segundos para construir un perfil vocal que pueda mantenerse de forma consistente en posteriores generaciones.
La compañía limita expresamente su uso a la propia voz del usuario o una voz para la que se disponga de los derechos correspondientes. Además, para crear una voz replicada exige una grabación verbal de consentimiento del propietario de la voz que debe coincidir con el hablante utilizado como referencia.
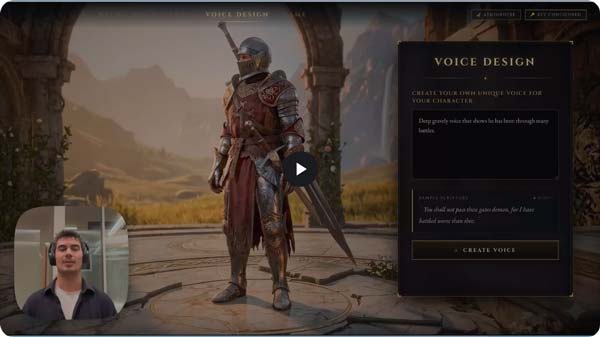
Gemini 3.8 Flash TTS también permite crear voces desde cero sin utilizar una grabación previa. Mediante lenguaje natural se pueden definir características como el papel del personaje, el acento, el estilo de interpretación o diferentes rasgos vocales.
Google anuncia además una biblioteca con más de 2.000 voces preparadas para producción, incluyendo variantes regionales como español de México, francés de Quebec o inglés escocés.
Más de 100 idiomas y control de cada línea del diálogo
Los dos modelos comparten la misma base de generación TTS, aunque están orientados a cargas de trabajo diferentes. La documentación actual de Google indica que Gemini 3.8 Flash TTS admite 130 idiomas, mientras que Flash-Lite TTS admite 101.
| Característica | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| Enfoque principal | Máxima fidelidad, interpretación y diseño de voz | Mayor rendimiento, baja latencia y eficiencia |
| Idiomas compatibles | 130 | 101 |
| Casos de uso | Audiolibros, narración, diálogos complejos, personajes y pronunciación avanzada | Doblaje a gran escala, lectura, agentes de voz y generación cotidiana |
| Replicación de voz | Sí | Sí |
| Control por instrucciones | Sí | Sí |
Una de las principales diferencias respecto a un sistema TTS tradicional es el nivel de dirección que ofrece. El usuario puede definir ritmo, emoción, acento y forma de interpretar cada línea, además de introducir eventos vocales como risas, suspiros, pausas o pequeñas interjecciones.
Los modelos también están preparados para conversaciones entre dos hablantes y para contenidos largos. Google asegura que Gemini 3.8 Flash TTS puede mantener la identidad de la voz, el timbre y otros rasgos durante narraciones de varios minutos y proyectos extensos.
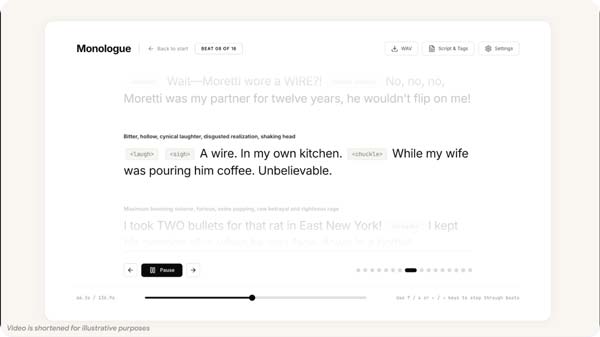
No debe confundirse esta tecnología con los modelos de conversación en tiempo real. En Hardmaniacos ya analizamos Gemini 3.8 Live y Gemini 3.8 Live Extended Thinking, que están orientados a mantener conversaciones de voz, utilizar contexto visual y ejecutar tareas mientras el usuario sigue hablando. Los nuevos modelos TTS están pensados principalmente para generar audio a partir de un texto previamente definido.
Consentimiento, SynthID y credenciales C2PA para las voces replicadas
La posibilidad de reconstruir una voz desde una muestra tan corta plantea riesgos evidentes de suplantación, por lo que Google ha acompañado la función con diferentes medidas de seguridad.
Para la replicación de voz, el sistema utiliza verificación de consentimiento. El propietario debe proporcionar una grabación verbal de consentimiento que coincida con la persona de la muestra utilizada para generar el perfil vocal.
Google indica asimismo que la replicación utiliza credenciales C2PA para aportar información de procedencia. De forma más general, todos los clips producidos por los modelos Gemini Audio incorporan SynthID, la marca de agua digital imperceptible de Google para ayudar a identificar audio generado mediante inteligencia artificial.
Esto no impide por sí solo que un audio pueda utilizarse fuera de contexto, pero añade mecanismos técnicos destinados a facilitar la identificación del contenido sintético y a limitar la creación de réplicas sin autorización.
Dónde están disponibles Gemini 3.8 Flash TTS y Flash-Lite TTS
Google inició el despliegue de ambos modelos el 23 de septiembre. Para desarrolladores, Gemini 3.8 Flash TTS y Flash-Lite TTS están disponibles mediante Gemini API y Google AI Studio.
La compañía también está integrándolos en sus productos:
- Gemini 3.8 Flash TTS: está llegando a Gemini Notebook para usuarios generales.
- Gemini 3.8 Flash-Lite TTS: se está incorporando a Google Vids.
- Gemini Enterprise: Google indica que el acceso mediante API llegará próximamente.
En el caso concreto de la replicación de voz mediante Google AI Studio, Google excluye actualmente el Espacio Económico Europeo, Reino Unido, Suiza e India, además de Illinois y Texas en Estados Unidos. Esto significa que la herramienta de replicación de AI Studio no está disponible actualmente desde España.
El anuncio no extiende expresamente esa misma nota regional a todas las posibles vías de acceso mediante API, por lo que no sería correcto asumir que todas ellas tienen exactamente las mismas restricciones sin documentación adicional.
Con estos modelos, Google amplía Gemini Audio desde las conversaciones de voz hacia un sistema de producción que puede diseñar personajes, mantener voces consistentes, dirigir interpretaciones completas y generar audio en más de un centenar de idiomas. La replicación a partir de 30 segundos es probablemente la función más llamativa, aunque su despliegue regional y los requisitos de consentimiento son una parte esencial de cómo Google ha decidido implementarla.
Fuentes: Google y Google AI for Developers.