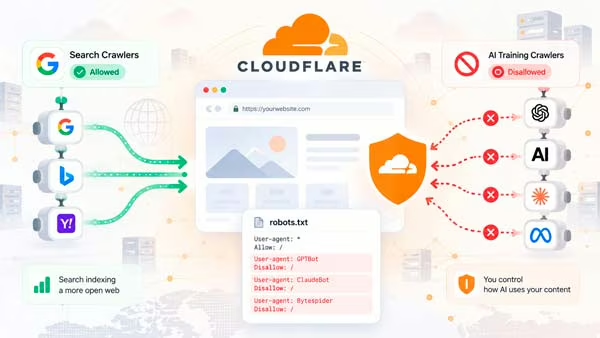
La función está disponible desde el 15 de septiembre de 2026 para clientes de Cloudflare en todos los planes, incluido el gratuito. El cambio intenta resolver uno de los mayores problemas que tenían hasta ahora los administradores de sitios web: algunos grandes rastreadores se utilizan tanto para búsqueda tradicional como para entrenamiento de IA, de modo que bloquearlos por completo podía perjudicar también la visibilidad en Google, Bing u otros servicios.
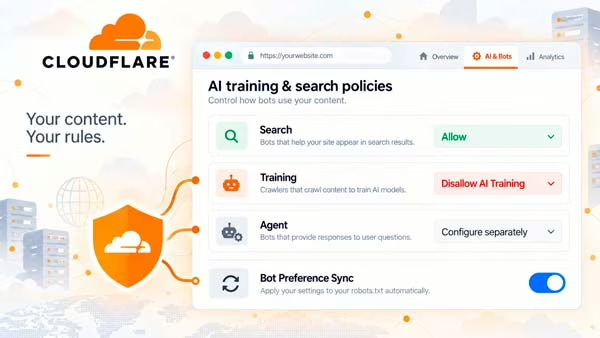
Cloudflare separa ahora tres comportamientos diferentes —Search, Training y Agent— y permite aplicar políticas distintas a cada uno. Así, una web puede seguir permitiendo el rastreo destinado a buscadores y expresar al mismo tiempo que su contenido no debe utilizarse para entrenar modelos.
Disallow AI Training separa el buscador del entrenamiento de IA
El problema está en los denominados mixed-use crawlers o rastreadores de uso mixto. Son bots que una misma compañía utiliza para más de una finalidad, por ejemplo indexar páginas para un buscador y obtener contenido relacionado con sistemas de inteligencia artificial.
Hasta ahora, bloquear completamente uno de estos bots podía tener una consecuencia no deseada: impedir también el rastreo que permite que una web aparezca en resultados de búsqueda.
Con Disallow AI Training, Cloudflare mantiene permitido el acceso destinado a búsqueda para los rastreadores que considera “Accountable”, mientras utiliza Bot Preference Sync para publicar en el archivo robots.txt la preferencia de que ese contenido no se emplee para entrenamiento.
Cloudflare utiliza además señales de contenido capaces de expresar por separado estas preferencias. Por ejemplo, un sitio puede indicar que permite el uso para búsqueda pero no para entrenamiento mediante una configuración equivalente a:
User-Agent: *
Content-Signal: search=yes, ai-train=no
Allow: /
Esto no significa que robots.txt sea por sí solo una barrera técnica. Cloudflare recuerda que el cumplimiento de estas directivas depende del operador del rastreador. La compañía combina por ello las preferencias publicadas en robots.txt con su clasificación de bots y, cuando es posible, con bloqueo a nivel de red de los rastreadores dedicados exclusivamente a entrenamiento que no necesitan acceder al sitio para mantenerlo en un buscador.
Entre estos últimos Cloudflare cita rastreadores de entrenamiento de Amazon, Anthropic, Meta y OpenAI, que pueden bloquearse sin afectar al rastreo de búsqueda porque utilizan bots separados para esas funciones.
Google ya separa Googlebot de Google-Extended
Google es uno de los casos más claros de por qué este nuevo control puede resultar útil para una web orientada al SEO.
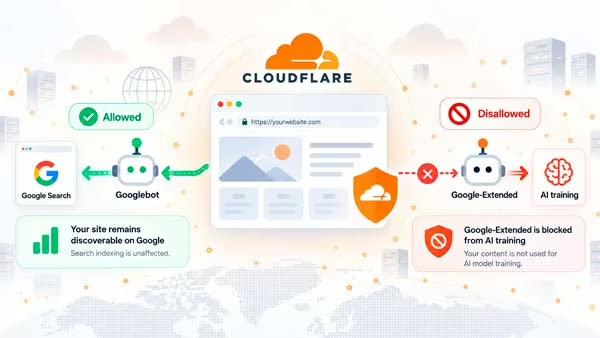
El rastreo que alimenta Google Search sigue asociado a Googlebot, mientras que los propietarios de webs pueden utilizar el token Google-Extended para controlar si el contenido rastreado por Google puede utilizarse para entrenar futuras generaciones de Gemini y para determinadas funciones de grounding.
Google confirma expresamente que bloquear Google-Extended no afecta a la inclusión de una web en Google Search ni se utiliza como señal de posicionamiento.
Cloudflare puede aprovechar esa separación para mantener el rastreo de búsqueda y publicar automáticamente la preferencia de no entrenamiento cuando el administrador selecciona Disallow AI Training.
La situación es parecida con Apple. Applebot-Extended permite indicar que el contenido no debe utilizarse para entrenamiento, mientras Apple afirma que esa decisión no perjudica el posicionamiento en sus funciones de búsqueda.
Bing todavía tiene una limitación importante
Microsoft forma parte junto a Apple y Google de los operadores que Cloudflare clasifica como “Accountable”, pero existe un matiz importante: Bing todavía no interpreta automáticamente esta nueva preferencia de no entrenamiento publicada por Cloudflare en robots.txt.
Actualmente Microsoft permite que los webmasters utilicen la etiqueta NOARCHIVE para indicar que su contenido no debe utilizarse para entrenar sus modelos generativos. La compañía asegura que NOARCHIVE no impide que esas páginas sigan apareciendo en los resultados tradicionales de Bing.
Microsoft está desarrollando además soporte para una preferencia de “no training” a nivel de dominio mediante robots.txt, pero Cloudflare sitúa su llegada prevista en principios de 2027.
Por tanto, un titular que afirmase que Disallow AI Training ya bloquea automáticamente el entrenamiento tanto en Google como en Bing sería demasiado amplio. Google ya dispone de la separación necesaria; Microsoft se ha comprometido a incorporarla, pero todavía no está plenamente integrada con esta opción de Cloudflare.
| Rastreador / compañía | Separar búsqueda y entrenamiento | Situación actual |
|---|---|---|
| Google / Googlebot | Sí | Google-Extended permite excluir entrenamiento sin afectar a Google Search |
| Apple / Applebot | Sí | Applebot-Extended permite excluir entrenamiento |
| Microsoft / Bingbot | Parcial | NOARCHIVE funciona actualmente; soporte vía robots.txt previsto para principios de 2027 |
| Amazon, Anthropic, Meta y OpenAI | Rastreadores separados | Cloudflare puede bloquear los bots de entrenamiento sin afectar a sus rastreadores de búsqueda cuando existan |
Ojo con usar “Block”: ahora también puede afectar al SEO
Junto con Disallow AI Training, Cloudflare ha cambiado el comportamiento de varias opciones existentes. Este punto es especialmente importante para administradores de webs que ya utilizaban el antiguo control Block AI Bots.
Desde el 15 de septiembre, las opciones Block y Block on pages with ads también pueden aplicarse a rastreadores de uso mixto como Googlebot, Bingbot y Applebot. Eso significa que seleccionar un bloqueo completo puede impedir el rastreo destinado a búsqueda y, por tanto, afectar a la visibilidad del sitio.
Para quienes quieran continuar apareciendo en buscadores pero rechazar el entrenamiento, Cloudflare recomienda utilizar específicamente Disallow AI Training en la categoría Training, manteniendo Search en Allow.
Las opciones disponibles quedan así:
- Allow: permite el tráfico del tipo seleccionado.
- Disallow AI Training: publica la preferencia de no entrenamiento y mantiene el rastreo de búsqueda de los operadores compatibles.
- Block on pages with ads: bloquea ese tipo de bot únicamente en páginas donde Cloudflare detecta publicidad.
- Block: bloquea completamente el rastreador, incluso cuando también se utiliza para búsqueda.
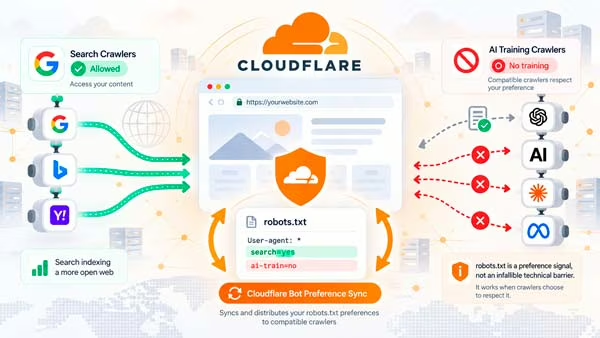
Cloudflare está retirando además el antiguo control genérico “Block AI Bots” en favor de estas políticas separadas para Search, Training y Agent. Managed Robots.txt también irá dejando paso a Bot Preference Sync.
Disponible incluso en el plan gratuito de Cloudflare
Cloudflare confirma que los nuevos controles están disponibles para todos sus clientes y en todos los planes. Se configuran a nivel de dominio desde los ajustes de seguridad.
Para un sitio que quiera mantener el SEO tradicional y rechazar el entrenamiento, la configuración básica es mantener Search en Allow y establecer Training en Disallow AI Training. Bot Preference Sync se encarga de sincronizar esa decisión con robots.txt.
En los nuevos dominios que monetizan mediante publicidad, Cloudflare propone precisamente una configuración predeterminada de este tipo: búsqueda permitida, entrenamiento desautorizado y agentes bloqueados en páginas con anuncios.
Esto es especialmente relevante para medios, blogs y webs financiadas mediante publicidad. El objetivo es evitar que proteger el contenido frente al entrenamiento obligue a renunciar al tráfico procedente de los buscadores.
Cloudflare ya había ido ampliando sus herramientas relacionadas con inteligencia artificial —en Hardmaniacos vimos recientemente Radar Researcher, su sistema para investigar qué ocurre en Internet mediante preguntas a una IA—, pero Disallow AI Training aborda un problema diferente: dar al propietario de una web más control sobre para qué puede utilizarse el contenido que rastrean los bots.
La solución todavía no es universal porque depende de que los operadores respeten o implementen estas señales. Google y Apple ya disponen de mecanismos específicos, mientras Microsoft ha comprometido la integración de su opción equivalente para principios de 2027. Aun así, Cloudflare consigue separar mucho mejor tres usos que hasta ahora se mezclaban con demasiada facilidad: búsqueda, entrenamiento y agentes de IA.
Fuentes: Cloudflare — Disallow AI Training y mixed-use crawlers, Cloudflare Developers — robots.txt y Content Signals, Google Developers — Google-Extended y Microsoft Bing — controles para el uso de contenidos.